Article 15 · Perspectives · Construire les capacités
De la donnée à la connaissance : quelle évolution pour les DPI ?
Infrastructures publiques numériques, référentiels partagés et services de connaissances : quelles capacités communes pour l’IA sectorielle ?
Sommaire
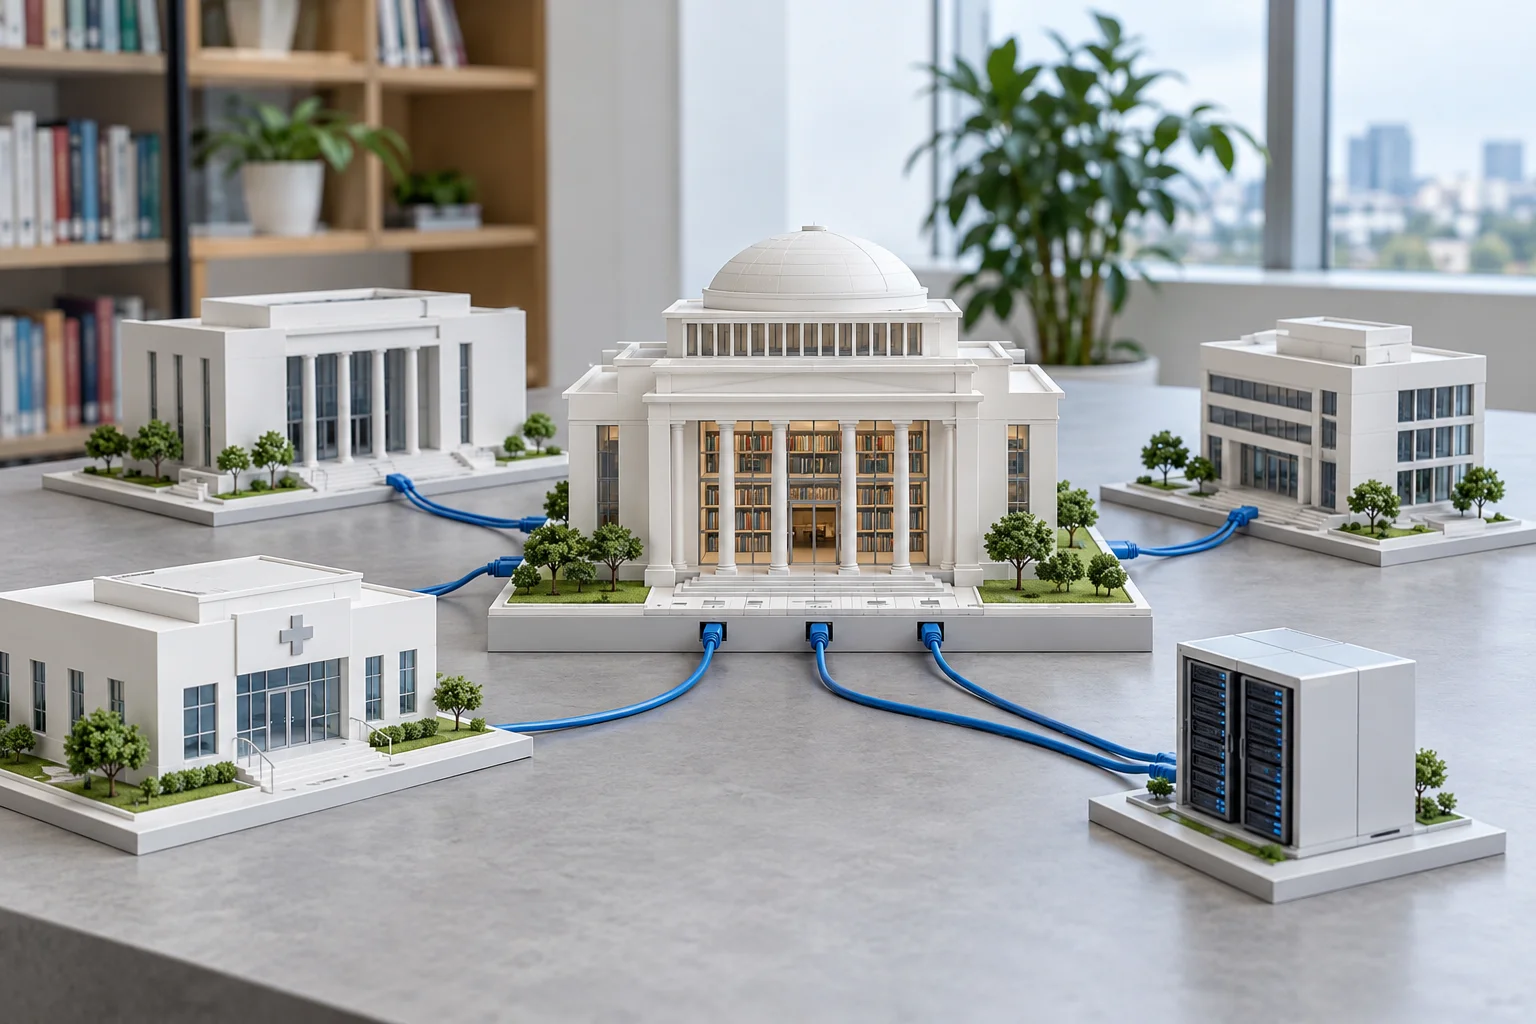
Et si les infrastructures numériques partageaient aussi des connaissances ?
Lorsqu’on évoque les infrastructures publiques numériques, ou Digital Public Infrastructure (DPI), on pense généralement aux dispositifs partagés qui permettent à plusieurs acteurs de fournir des services : identification, paiements et échanges de données figurent parmi les exemples les plus fréquemment discutés. Leur intérêt réside notamment dans la possibilité de réutiliser des capacités communes plutôt que de reconstruire les mêmes fonctions dans chaque application.
Mais le développement de l’intelligence artificielle soulève une question complémentaire. Lorsque plusieurs administrations, entreprises ou startups doivent mobiliser les mêmes connaissances de référence, faut-il également organiser certains patrimoines et services de connaissances comme des capacités partagées ?
Cette interrogation ne signifie pas que toute base documentaire ou tout assistant RAG doit devenir une DPI. Elle invite à examiner, de manière rigoureuse, les conditions dans lesquelles la mutualisation de connaissances pourrait compléter les infrastructures numériques existantes.
Les DPI : des capacités communes, pas une accumulation de plateformes
Une infrastructure publique numérique ne se définit pas seulement par sa technologie. Elle vise à fournir des capacités réutilisables, accessibles dans un cadre de gouvernance approprié, afin de soutenir plusieurs services et plusieurs acteurs.
Les dispositifs d’identité, de paiement et d’échange de données sont des exemples importants, mais leur mise en œuvre varie selon les pays et les contextes. Leur conception appelle notamment des exigences d’interopérabilité, de sécurité, de protection des données, d’inclusion et de responsabilité.
Une DPI n’est donc pas synonyme de « grande plateforme publique ». Son intérêt doit être apprécié au regard de la fonction partagée, de ses utilisateurs, des règles d’accès et de la valeur créée par sa réutilisation.
Ce cadre fournit un point de départ pour examiner une éventuelle nouvelle catégorie de capacités communes liées aux connaissances.
Pourquoi les données ne suffisent pas toujours
Une donnée peut indiquer qu’une procédure a été effectuée, qu’un équipement a produit une mesure ou qu’un élève a obtenu un résultat. Pour concevoir un service d’IA métier, il faut souvent connaître aussi les définitions, les règles, les méthodes et les conditions qui donnent du sens à ces informations.
Dans l’administration, une base peut enregistrer des demandes ; un référentiel de connaissances précise les pièces requises, les critères d’éligibilité et les exceptions. Dans l’éducation, une base d’exercices ne remplace pas la connaissance des notions, des prérequis et des méthodes pédagogiques. Dans l’agriculture, des observations de terrain doivent être interprétées au regard de connaissances agronomiques contextualisées.
Les données et les connaissances sont donc complémentaires. Les premières ne se transforment pas automatiquement en règles ou en explications fiables. Leur articulation peut nécessiter des compétences spécialisées d’ingénierie documentaire, de formalisation métier, de sémantique et de gouvernance.
Du document partagé au service de connaissances
Imaginons que plusieurs applications administratives aient besoin de consulter les mêmes textes et procédures. Chacune pourrait constituer son propre corpus, produire ses synthèses, organiser ses index et gérer ses mises à jour. Cette duplication peut entraîner des coûts et des incohérences.
Une autre approche consisterait à organiser certaines ressources de référence dans un dispositif commun, avec des versions, des métadonnées, des statuts de validation et des interfaces d’accès. Les applications pourraient alors retrouver des passages, consulter des règles ou vérifier certaines conditions à partir de services partagés.
Le service de connaissances ne se confondrait pas avec les applications qui l’utilisent. Celles-ci conserveraient leurs interfaces, leurs fonctions et leurs responsabilités propres.
Une telle organisation ne serait pertinente que si les usages sont suffisamment communs, les droits maîtrisés, la qualité garantie et le coût de coordination justifié par les bénéfices attendus.
Trois niveaux de mutualisation à distinguer
Le premier niveau concerne les méthodes et compétences. Plusieurs organisations peuvent partager des procédures de qualification documentaire, des schémas de métadonnées, des outils de contrôle et des spécialistes rares, sans mettre leurs contenus en commun.
Le deuxième niveau concerne les composants techniques : catalogues, services de recherche, mécanismes de provenance, gestion des versions ou interfaces d’accès. Ces composants peuvent être réutilisés par différents patrimoines sectoriels.
Le troisième niveau concerne les contenus et services de connaissances eux-mêmes : référentiels de notions, règles institutionnelles, classifications ou ressources qualifiées pouvant être utilisés par plusieurs applications autorisées.
Ces trois niveaux ne présentent pas les mêmes exigences de financement, de responsabilité et de protection. Il serait donc imprudent de les traiter comme un seul projet indifférencié.
L’exemple pédagogique : un patrimoine commun, plusieurs applications
Reprenons le cas d’une startup qui développe un assistant de mathématiques pour les élèves ivoiriens. Une autre startup souhaite créer une plateforme d’exercices ; une troisième conçoit un outil d’aide aux enseignants.
Ces acteurs pourraient avoir besoin de référentiels communs : programmes applicables, notions, niveaux, relations de prérequis et ressources pédagogiques qualifiées. Sous réserve des autorisations nécessaires, certaines de ces ressources pourraient être préparées une fois, entretenues collectivement et accessibles au moyen de services documentés.
Les entreprises conserveraient la liberté de concevoir des expériences différentes et d’utiliser les modèles d’IA adaptés à leurs objectifs. La mutualisation porterait sur ce qui gagne réellement à être partagé.
Ce scénario reste une hypothèse d’architecture. Il nécessite d’examiner les droits sur les contenus, les responsabilités pédagogiques, les coûts et les modalités de gouvernance avant toute décision.
L’exemple administratif : l’autorité des sources est décisive
Dans le secteur public, un service partagé pourrait faciliter l’accès à des procédures ou à des référentiels institutionnels. Mais la difficulté ne consiste pas uniquement à centraliser des documents.
Il faut distinguer les textes officiels, les synthèses explicatives et les interprétations produites par des outils. Il faut identifier l’autorité compétente, les dates d’application, les exceptions et les modifications successives.
Un système peut techniquement rendre une information accessible sans avoir l’autorité pour la déclarer applicable. La validation institutionnelle et l’autorisation de publication doivent donc être explicites.
Le caractère partagé du service accroît cette responsabilité : une erreur dans un référentiel commun peut se propager à plusieurs applications. Les mécanismes de suspension, de correction et de notification des changements deviennent alors essentiels.
À quelles conditions parler réellement de DPI ?
Un patrimoine de connaissances n’acquiert pas le statut de DPI simplement parce qu’il est financé par une institution publique, qu’il possède une API ou qu’il utilise une architecture RAG.
Il faudrait notamment démontrer l’existence d’une fonction commune suffisamment importante, de plusieurs usages réels, d’une architecture interopérable, de règles d’accès transparentes, d’une gouvernance responsable et de moyens de maintenance durables.
Il faudrait également apprécier l’intérêt public, l’inclusion, la protection des données, les risques de concentration et la possibilité de permettre à différents acteurs de développer leurs propres services.
Dans certains cas, un service de connaissances pourrait constituer un composant d’une infrastructure numérique partagée. Dans d’autres, il resterait plus pertinent de le gérer comme un produit sectoriel, un service mutualisé contractuel ou un patrimoine institutionnel interne.
Cette distinction est essentielle pour éviter de transformer le concept de DPI en une étiquette appliquée à tout projet numérique.
Une architecture possible en couches
Une première couche réunirait les sources autorisées : documents, données, experts et référentiels. Une deuxième organiserait les transformations : extraction, explicitation, structuration, qualification et traçabilité.
Une troisième couche contiendrait les produits de connaissances validés : corpus, fiches, taxonomies, graphes ou règles, selon les besoins. Une quatrième proposerait les services d’accès : recherche, interrogation structurée, interfaces de vérification et gestion des permissions.
Enfin, les applications consommatrices — assistants, plateformes métier ou outils d’analyse — mobiliseraient ces services en conservant leurs propres mécanismes de contrôle et d’évaluation.
Il s’agit d’une architecture fonctionnelle illustrative, et non d’un schéma national arrêté. Les couches pourraient être réparties entre plusieurs institutions et infrastructures.
Les compétences invisibles deviennent des fonctions d’infrastructure
Une capacité commune de connaissances exige davantage que des serveurs et des API. Elle mobilise l’ingénierie documentaire pour qualifier les sources, l’ingénierie des connaissances pour formaliser les règles, la sémantique pour harmoniser les concepts et l’ingénierie des données pour organiser les flux.
Elle nécessite également l’expertise sectorielle pour valider les contenus, la gouvernance pour définir les responsabilités et l’évaluation pour vérifier que les applications utilisent correctement les ressources.
Ces compétences ne doivent pas être nécessairement concentrées dans une seule institution. Certaines peuvent être organisées en équipes sectorielles, en centres de services, en laboratoires ou auprès de prestataires spécialisés.
Le défi est d’organiser leur coopération, leurs standards et leurs responsabilités de manière durable.
Les risques d’une mutualisation mal conçue
Un dispositif partagé peut produire des économies de duplication, mais il peut aussi créer de nouveaux risques. Une erreur de référence peut affecter plusieurs services. Une architecture fermée peut rendre les utilisateurs dépendants d’un fournisseur ou d’un opérateur unique.
Des droits mal définis peuvent empêcher la réutilisation légitime des ressources. Des contrôles d’accès insuffisants peuvent exposer des informations confidentielles. Une gouvernance trop centralisée peut ralentir l’actualisation des connaissances sectorielles.
Il faut donc examiner les mécanismes de sécurité, de confidentialité, de portabilité, de contestation, de correction et de continuité. Les utilisateurs doivent savoir quelle source est mobilisée et quelles limites s’appliquent.
La mutualisation ne doit pas être considérée comme un objectif en soi. Elle doit démontrer un bénéfice supérieur aux coûts et aux risques qu’elle introduit.
Quel modèle de gouvernance et de financement ?
Plusieurs modèles sont envisageables : gestion par une institution compétente, coopération interinstitutionnelle, partenariat avec des organismes de recherche ou prestation contractualisée auprès d’opérateurs spécialisés.
Les responsabilités doivent être réparties entre producteurs de sources, responsables de validation, opérateurs techniques et utilisateurs des services. Les règles de modification, de publication, d’accès et de retrait doivent être documentées.
Le financement doit couvrir non seulement la construction initiale, mais aussi les licences, les experts métier, les mises à jour, les contrôles, les interfaces et la continuité du service.
Un patrimoine partagé sans budget de maintenance risque de devenir rapidement obsolète. La soutenabilité doit donc être examinée dès le cadrage.
Une méthode de décision progressive pour les acteurs publics
Avant d’engager une infrastructure commune, il serait pertinent de sélectionner un cas d’usage limité et de vérifier que plusieurs acteurs rencontrent effectivement le même besoin de connaissances.
Le pilote pourrait produire un inventaire des sources, un registre des droits, un petit référentiel qualifié, un service d’accès documenté et un protocole de tests. Il devrait comparer les résultats obtenus avec ceux de solutions indépendantes.
Les critères d’appréciation pourraient inclure la qualité des réponses, les coûts de production et de maintenance, la facilité d’intégration, la réutilisation effective et les risques de gouvernance.
Ce n’est qu’après ces vérifications qu’une décision de mutualisation élargie, voire de qualification comme composante d’une DPI, pourrait être instruite.
Une perspective pour les capacités nationales d’IA
Pour la Côte d’Ivoire, la réflexion sur les services communs de connaissances peut contribuer à relier les stratégies de transformation numérique aux besoins concrets des secteurs d’activité.
Elle invite à se demander quels patrimoines de référence méritent d’être mieux structurés, quels acteurs sont habilités à les valider, quelles compétences doivent être développées et quels services pourraient être réutilisés par plusieurs applications.
Elle ne constitue pas l’annonce d’une nouvelle DPI nationale ni la décision de centraliser les connaissances des institutions. Elle propose une grille d’analyse permettant d’évaluer des opportunités futures sur la base des usages, des droits, des coûts et des responsabilités.
Conclusion — De la circulation des données à la mobilisation des connaissances
Les infrastructures publiques numériques peuvent faciliter la circulation de services et de données entre acteurs. Le développement des applications d’IA sectorielles fait apparaître un besoin complémentaire : rendre certaines connaissances fiables, accessibles et réutilisables dans des conditions maîtrisées.
Il serait excessif d’en conclure que tous les patrimoines de connaissances doivent devenir des DPI. La bonne question est de déterminer lesquels justifient une organisation commune et selon quelles garanties.
Cette réflexion élargit le rôle des compétences invisibles de l’IA. Elles ne servent pas uniquement à alimenter une application isolée : elles peuvent contribuer, lorsque les besoins le justifient, à produire et maintenir des capacités de connaissances partagées au bénéfice de plusieurs acteurs.
Nature du texte : L’extension possible des DPI aux services de connaissances constitue une hypothèse prospective, non une classification officiellement adoptée ni une décision de politique publique. Références externes et cadrage DPI à approfondir lors de la revue scientifique.